
Hva må være på plass før virksomhetsdata brukes med KI?
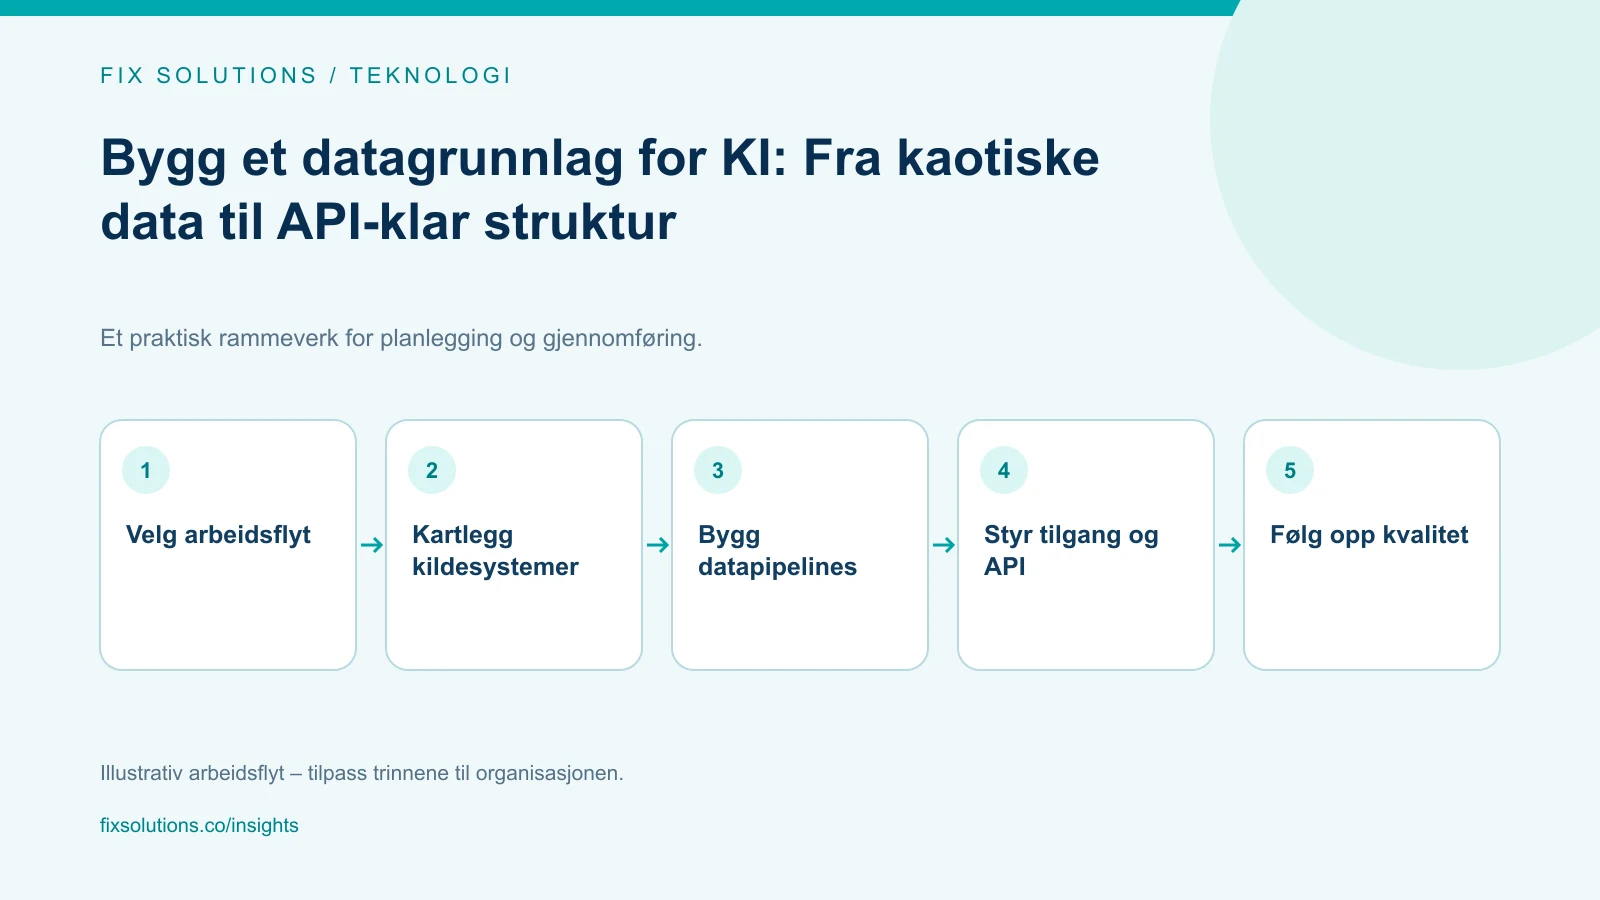
KI-løsninger blir mer nyttige når de får tilgang til data som er relevant, oppdatert, autorisert og sporbar til en pålitelig kilde. Start med én arbeidsflyt, identifiser systemene som inneholder de autoritative opplysningene, og bygg styrte pipelines og API-er som gjør dataene anvendelige. En datasjø kan inngå i løsningen, men flytting av data alene gjør dem ikke korrekte eller klare for en LLM.
En pilot kan fungere godt med et lite, manuelt kuratert datasett. Produksjonsbruk reiser vanskeligere spørsmål: Hvilken kundepost gjelder? Hvor raskt blir en ordreendring tilgjengelig? Har brukeren tilgang til dokumentet? Hvem retter feil i kildesystemet? Dette er spørsmål om dataansvar og integrasjon, ikke bare om modellvalg.
Begynn med en konkret arbeidsflyt
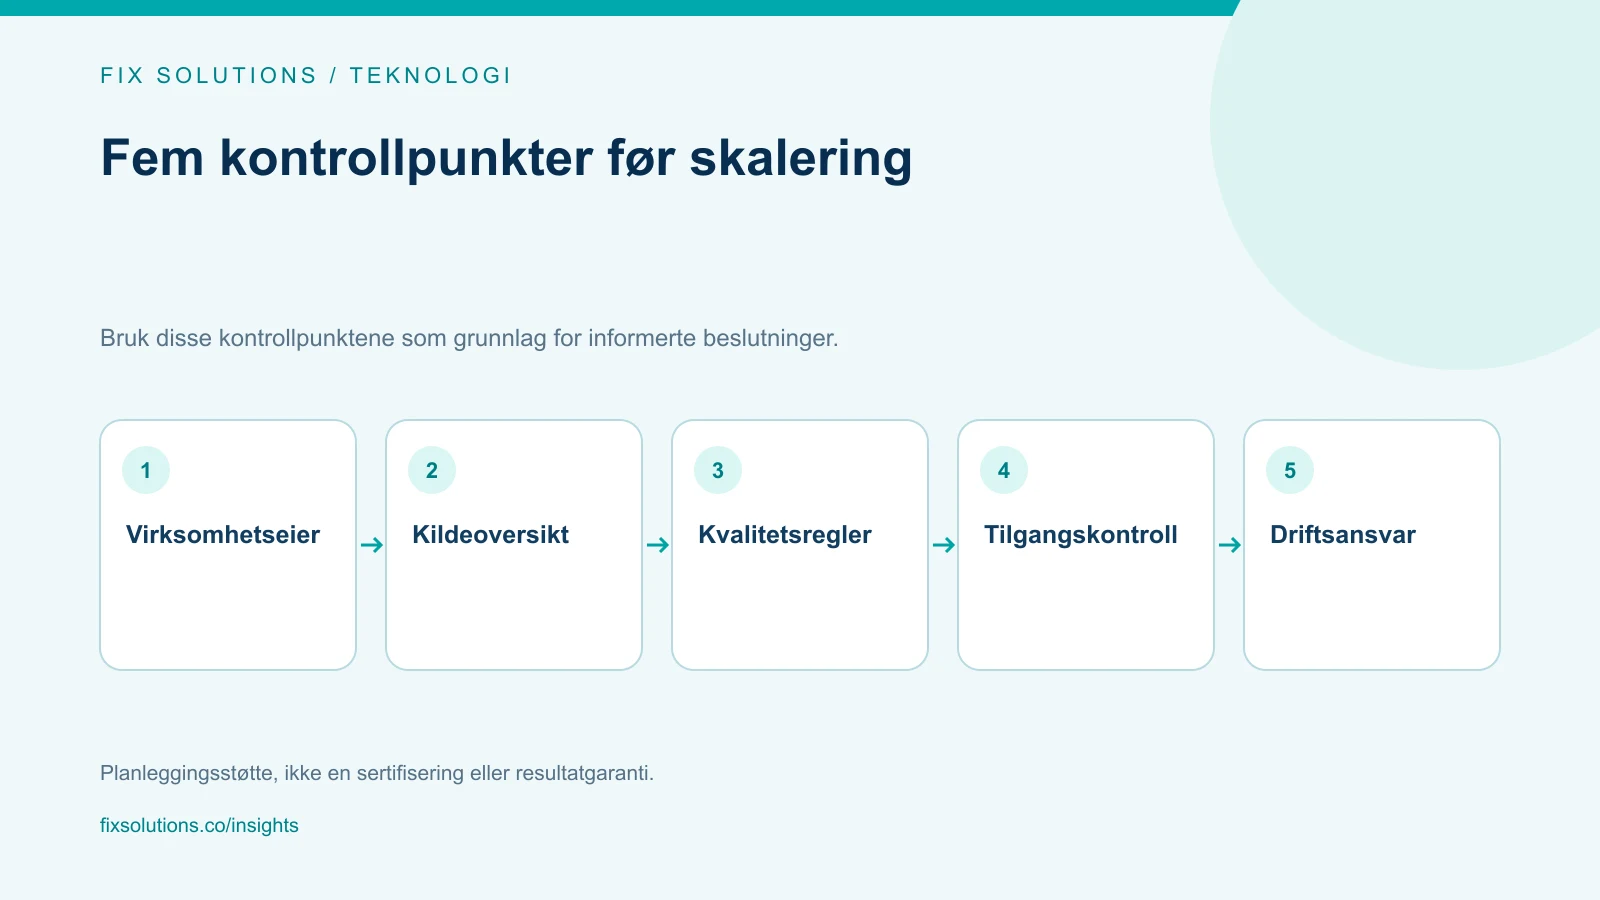
Velg en oppgave med en tydelig virksomhetseier. Det kan være å gi en servicemedarbeider relevant kundekontekst, hjelpe en planlegger med å undersøke et avvik, eller gjøre styrte driftsdata tilgjengelige for analyse. Beskriv hva brukeren skal beslutte eller gjennomføre, hvilken dokumentasjon som kreves, og hva som fortsatt skal godkjennes av et menneske.
Kartlegg hvor hver viktig opplysning kommer fra. CRM, ERP, datavarehus, dokumentarkiv og regneark kan inneholde ulike versjoner av samme kunde eller produkt. Definer system of record, identifikatorer, oppdateringsansvar og regler for konflikter. Hvis organisasjonen selv ikke vet hvilken verdi som er riktig, vil et AI-grensesnitt gjøre motsetningen lettere å søke i, ikke automatisk fjerne den.
Lag en datakildeoversikt med eier, grensesnitt, oppdateringsfrekvens, følsomhet, kvalitet og avhengigheter. Denne oversikten viser om kilden kan integreres via et støttet API, krever en hendelsesstrøm eller må lastes i en kontrollert batch.
Bygg integrasjonslaget før dere åpner for bred tilgang
En pipeline bør ha tydelige kontrakter: skjema, identifikatorer, tidsstempler, versjoner, retry-regler, håndtering av duplikater og signaler for utdaterte data. Gjør transformasjoner synlige og testbare. Hvis prosessen kobler poster eller endrer forretningsdefinisjoner, bør det være mulig å spore hvordan resultatet ble til.
En datasjø eller lakehouse kan samle ulike datatyper, men plattformvalget bør følge behov for forsinkelse, volum, spørringer, datalokasjon, kompetanse, eksisterende skybruk og gjenoppretting. Et sentralt lager uten eierskap og brukbare datakontrakter kan bli en større ny silo.
Eksponer godkjente data gjennom API-er, søketjenester eller andre kontrollerte grensesnitt. Håndhev identitet og tilgang i applikasjonen og kildesystemet, ikke bare i en prompt. Begrens hvor mye en modell kan hente, loggfør forespørsler på en forsvarlig måte og vis kildehenvisninger der svaret brukes i arbeid. Manglende eller motstridende opplysninger bør vises som usikkerhet, ikke erstattes av en overbevisende gjetning.
Eksempel: fra kundesak til kontrollert kontekst
En servicemedarbeider skal få et sammendrag av en kundesak før samtalen. Dataene kan ligge i CRM, ERP og et dokumentarkiv. Før en modell kobles til, avklarer teamet hvilken kunde-ID som brukes på tvers, hvilke notater rollen har lov til å se, og hvor ofte status endres. Integrasjonslaget henter bare tillatte felt, merker tidspunkt og kilde, og returnerer lenker til relevante poster.
Hvis CRM og ERP gir ulike verdier, bør løsningen vise uoverensstemmelsen eller henvise medarbeideren til kilden—ikke velge én verdi uten en godkjent regel. Dette gjør datakvalitet og tilgang synlig i arbeidsflyten og gir en konkret måte å evaluere om løsningen faktisk hjelper.
Gjør datakvalitet målbar
Definer kvalitetsregler for den valgte arbeidsflyten: fullstendighet, gyldighet, unikhet, konsistens og aktualitet. Bestem hva som skjer når data er forsinket eller korrigert. Kjør kontroller ved innlesing og før kritisk bruk. Varsler må ha en ansvarlig dataeier og nok kontekst til å finne feilen i kilden.
Skill mellom kvaliteten på kildedata og kvaliteten på modellens svar. Datatester kan kontrollere at felt følger godkjente regler. Modellevaluering kan undersøke om et svar bruker relevante poster, viser kilder og innrømmer usikkerhet. Begge deler trenger eiere, testsett og oppfølging.
Personopplysninger og forretningskritiske data krever kontroll med formål, tilgang, lagring og leverandør. Bruk minste privilegium og maskering der det er mulig. Vurder faktiske dataflyter og avtaler med sikkerhets- og personvernansvarlige før data sendes til en ekstern modell. EUs personvernforordning (GDPR) er en primærkilde for behandling av personopplysninger; den konkrete anvendelsen må vurderes for virksomheten og løsningen.
Dataansvar må ikke forveksles med plattformansvar. Plattformteamet kan tilby pipeline-standarder, tilgangsmønstre og overvåking, mens fagområdet eier definisjoner og korrigering av virksomhetsdata. Et katalogverktøy kan dokumentere ansvar, men bare en avtalt arbeidsprosess sørger for at feil faktisk blir rettet.
For språkmodeller bør dere evaluere både hentede kilder og genererte svar. Opprett et godkjent testsett med vanlige spørsmål, manglende data, motstridende poster og forespørsler som brukeren ikke har tilgang til. Registrer om systemet gir et sporbar svar, ber om avklaring eller avstår når grunnlaget ikke er godt nok. Bruk testsettet på nytt når skjema, kilder eller modellversjon endres.
Gå fra pilot til støttet løsning
Hold den første produksjonsversjonen smal. Koble til minimumskildene som trengs, utpek en tjenesteeier og en dataforvalter, og dokumenter hvem som kan bruke funksjonen. Overvåk pipeline-ferskhet, feil ved innlasting, API-tilgjengelighet, kostnad og rapporterte problemer.
Evaluer hele arbeidsflyten, ikke bare prompten. Ta med manglende poster, motstridende identifikatorer, forsinkede oppdateringer, avviste tilganger og spørsmål systemet ikke bør besvare. Sammenlign med en baseline, for eksempel tiden det tar å undersøke et avvik, eller andelen saker der brukeren finner nødvendig informasjon. Ikke bruk antall genererte svar som mål på virksomhetsverdi.
Planlegg gjenoppretting og endringer før lansering. Teamet må kunne kjøre en mislykket innlasting på nytt, rette en mapping, rulle tilbake en skjemaversjon og deaktivere KI-funksjonen uten å miste den underliggende arbeidsprosessen. Dokumenter eierskap til koblinger, pipelines, datadefinisjoner og modellkonfigurasjon.
Skaler ved å gjenta mønsteret der det passer. Gjenbruk identitet, logging og kvalitetskontroller, men la fagområdene beholde ansvar for sine definisjoner. Felles standarder trenger ikke bety at ett sentralt team skal tolke alle forretningsdata.
Ofte stilte spørsmål
Må vi bygge en ny datasjø før vi begynner med KI?
Ikke nødvendigvis. Et avgrenset behov kan dekkes gjennom et styrt API eller et eksisterende datavarehus. Vurder datakvalitet, tilgang, sporbarhet og forsinkelse før dere velger ny plattform.
Bør en LLM spørre produksjonsdatabasen direkte?
Vanligvis bør den bruke et kontrollert grensesnitt. Det kan håndheve tilgang, begrense data, loggføre bruk og sikre sporbar kontekst.
Hvem har ansvar for datakvaliteten?
Ansvaret deles mellom kildeeier, dataforvalter, plattformteam og eier av KI-produktet. Utpek en person som skal følge opp hver vesentlig datafeil.
Bygg dataveien rundt et reelt behov
Et pålitelig KI-grunnlag begynner med eierskap, integrasjon og tilgangskontroll—not med en modell som kobles til alle systemene. Start med én arbeidsflyt, dokumenter datakildene og finansier driften som skal holde løsningene oppdaterte. FIX Solutions kan bidra med avgrensning av integrasjon og dataplattformarbeid gjennom IT-utviklingstjenester.